Découvrez l’histoire complète de Gemini, l’intelligence artificielle de Google DeepMind. De la fusion historique de 2023 aux modèles Gemini 1.5 et 2.0, analyse technique, chercheurs clés, points forts et limites.
Mots-clés principaux : Gemini Google, Google DeepMind, IA multimodale, Demis Hassabis, Jeff Dean, Gemini 1.5 Pro, architecture MoE, fenêtres de contexte.
De la riposte à la refondation : la genèse du projet Gemini
L’histoire de Gemini ne commence pas dans un laboratoire de recherche classique, mais dans une cellule de crise. À la fin de l’année 2022, le lancement de ChatGPT par OpenAI ébranle la position de monopole culturel et technologique de Google. Malgré une décennie de leadership scientifique incontesté — marquée par l’invention de l’architecture Transformer en 2017 —, la firme de Mountain View se retrouve accusée d’inertie.
Pour répondre à cette menace existentielle, Sundar Pichai ordonne en avril 2023 la fusion de deux entités rivales mais complémentaires : Google Brain, pionnier du deep learning, et DeepMind, le laboratoire londonien célèbre pour AlphaGo. Cette union donne naissance à Google DeepMind.
Le mandat confié à cette nouvelle structure est unique : concevoir une architecture d’intelligence artificielle entièrement nouvelle, capable d’outrepasser les limites des modèles de langage purement textuels en intégrant nativement la multimodalité.
+-------------------------------------------------------------------+
|                        GOOGLE DEEPMIND                            |
|                                                                   |
|   +-----------------------+         +-------------------------+   |
|   |     Google Brain      |    +    |    DeepMind (Londres)   |   |
|   |  (Transformers, PaLM) |         |  (AlphaGo, RL, Systems) |   |
|   +-----------------------+         +-------------------------+   |
+-------------------------------------------------------------------+
                                  |
                                  v
                    PROJET GEMINI (Code Red - 2023)
Les architectes : qui sont les cerveaux derrière Gemini ?
Le développement de Gemini repose sur le travail de plusieurs figures majeures de l’informatique moderne et des réseaux de neurones.
- Demis Hassabis : Cofondateur de DeepMind et nommé PDG de Google DeepMind après la fusion. Hassabis a insufflé la rigueur méthodologique issue du jeu d’échecs et des neurosciences, orientant le projet vers des capacités de planification complexe et d’apprentissage par renforcement.
- Jeff Dean : Ancien directeur de Google AI, nommé Chief Scientist de l’entité fusionnée. Légende du génie logiciel chez Google (co-inventeur de MapReduce et TensorFlow), Dean a supervisé l’infrastructure de calcul à grande échelle et l’optimisation des puces TPU (Tensor Processing Unit).
- Oriol Vinyals : VP de la recherche chez Google DeepMind et chercheur principal sur Gemini. Vinyals a joué un rôle déterminant dans la conception de l’architecture multimodale native, évitant le simple assemblage de modèles spécialisés.
- Sergey Brin : Le cofondateur de Google est sorti de sa retraite opérationnelle pour travailler directement avec les équipes de recherche, participant au codage et au réglage fin des paramètres des premiers modèles.
- Koray Kavukcuoglu : Directeur de la recherche chez DeepMind, il a coordonné l’alignement de la sécurité et l’intégration des techniques d’apprentissage par renforcement à partir de rétroaction humaine (RLHF).
Chronologie des versions : du fiasco initial à la maturité technique
1. La préhistoire : LaMDA, PaLM et les faux départs (2021 — début 2023)
Avant Gemini, Google a expérimenté avec LaMDA (Language Model for Dialogue Applications), célèbre pour les controverses sur une prétendue « conscience », puis avec PaLM (Pathways Language Model) en 2022. La première tentative commerciale, le chatbot Bard lancé début 2023, s’appuyait sur PaLM 2. Entaché d’erreurs d’affichage lors de sa première démonstration publique, Bard a souffert de la comparaison avec GPT-4, incitant Google à accélérer le projet Gemini.
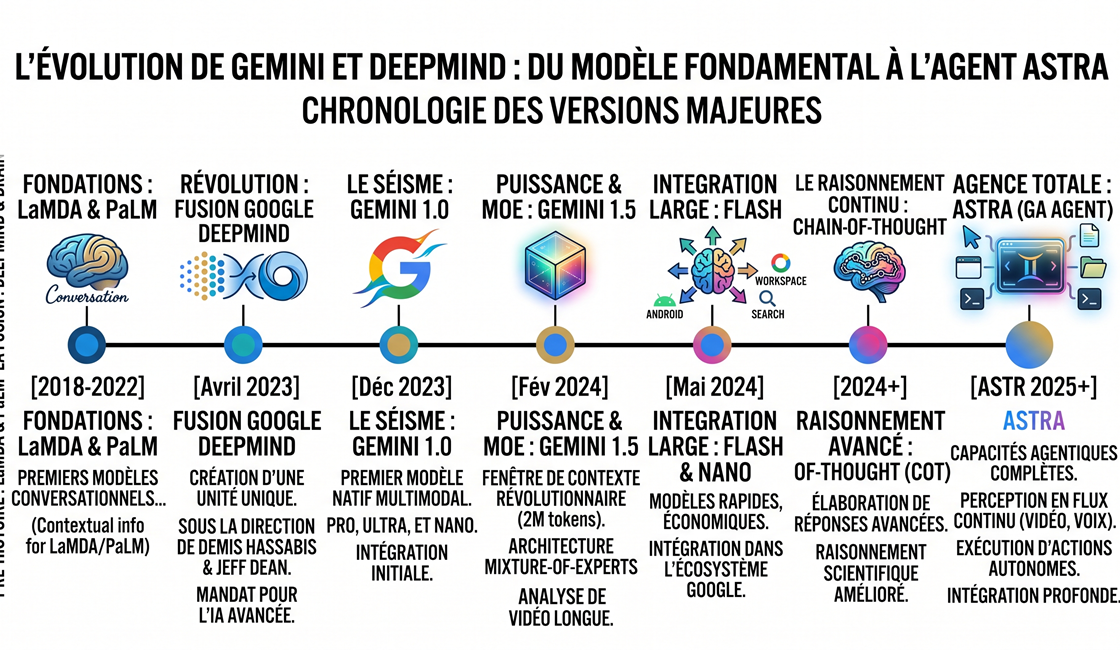
2. Gemini 1.0 : La première brique multimodale (Décembre 2023)
Dévoilé le 6 décembre 2023, Gemini 1.0 marque le lancement officiel de la marque. La famille se déclinait en trois tailles :
- Gemini Nano : Conçu pour s’exécuter localement sur les appareils mobiles (Pixel 8 Pro).
- Gemini Pro : Destiné aux tâches générales et déployé dans Bard (rebaptisé Gemini peu après).
- Gemini Ultra : Le modèle le plus massif, conçu pour rivaliser directement avec GPT-4 sur le benchmark MMLU (Massive Multitask Language Understanding).
Si Gemini 1.0 Ultra affichait des performances impressionnantes en résolution de problèmes complexes, le lancement a été entaché par une vidéo de démonstration au montage trompeur, suggérant une réactivité en temps réel que le modèle n’offrait pas encore.
3. Gemini 1.5 : La rupture de la fenêtre de contexte (Février — Mai 2024)
L’annonce de Gemini 1.5 Pro en février 2024 a constitué un tournant technique majeur. Google a abandonné l’architecture denses traditionnelle au profit d’un système à mélange d’experts (MoE – Mixture-of-Experts).
La véritable innovation résidait dans la taille de la fenêtre de contexte : portée initialement à 1 million de tokens, puis étendue à 2 millions de tokens. Gemini 1.5 Pro est ainsi devenu capable d’absorber en une seule requête :
- Plus d’une heure de vidéo à 10 FPS ;
- Plus de 11 heures d’audio ;
- Plus de 30 000 lignes de code ;
- Plus de 700 000 mots de texte.
Le lancement de Gemini 1.5 Flash en mai 2024 a complété l’offre avec un modèle distillé, extrêmement rapide et économique, adapté aux applications d’entreprise nécessitant une faible latence.
4. Gemini 2.0 et l’ère des agents (2024 — 2026)
Les itérations ultérieures de la famille Gemini ont concrétisé la vision initiale du Projet Astra : transformer le modèle de langage en un assistant agentique capable de percevoir le monde en flux continu vidéo et audio sans latence perceptible. Gemini 2.0 a introduit la capacité d’interagir avec les interfaces graphiques (ordinateur, navigateur) et d’exécuter des chaînes d’actions autonomes.
+------------------------------------------------------------------------+
|                      ÉVOLUTION DE LA GAMME GEMINI                      |
|                                                                        |
|  2023 (v1.0)           2024 (v1.5)               2025-2026 (v2.0+)    |
|  Dense Architecture    Mixture-of-Experts (MoE)   Native Agentic Flow  |
|  32k context           1M -> 2M tokens context    Realtime Audio/Video |
|  Ultra / Pro / Nano    Pro / Flash               Astra / Flash-Native |
+------------------------------------------------------------------------+
Évaluation critique : avantages et inconvénients des générations
| Version | Points forts | Limites et controverses |
| Gemini 1.0 (Ultra / Pro) | • Premier modèle nativement multimodal (texte, image, son, code). • Bonnes performances sur le code Python et le raisonnement logique. | • Démo marketing initiale controversée. • Hallucinations fréquentes sur les questions factuelles complexes. • Intégration initiale laborieuse dans l’écosystème. |
| Gemini 1.5 (Pro / Flash) | • Fenêtre de contexte gigantesque (2 M+ tokens). • Excellent rapport coût/performance avec la version Flash. • Traitement exceptionnel des vidéos longues sans découpage. | • Tendance au refusal (refus excessif de répondre) sur certains thèmes. • Fiasco de la génération d’images historiques (Imagen 3 / surcompensation des biais). |
| Gemini 2.0 / Astra | • Interaction temps réel fluide (voix et vidéo). • Capacités d’action agentique (navigation, exécution de scripts). • Intégration profonde avec la suite Google Workspace et Android. | • Consommation énergétique et coût des requêtes en temps réel. • Dépendance forte aux données personnelles de l’écosystème Google. |
Les piliers techniques : ce qui distingue Gemini de ses concurrents
La multimodalité native dès l’apprentissage
Contrairement aux systèmes concurrents qui assemblent des modèles distincts (un modèle de vision couplé à un modèle de langage), Gemini a été entraîné dès la phase de pré-entraînement sur des données entrelacées : texte, images, signaux audio et séquences vidéo. Le modèle comprend ainsi les relations spatiotemporelles d’une vidéo ou la structure harmonique d’un fichier audio sans passer par une transcription textuelle intermédiaire.
L’infrastructure matérielle : le rôle clé des TPU
L’un des avantages stratégiques de Google réside dans la maîtrise de sa chaîne matérielle. Gemini n’a pas été entraîné exclusivement sur des puces NVIDIA, mais sur les TPU v4, TPU v5p et Trillium de Google. Cette indépendance matérielle permet d’optimiser l’interconnexion entre les processeurs via des topologies réseau spécifiques (Supercomputers TPU), réduisant significativement le temps d’entraînement des architectures à très grand nombre de paramètres.
        +-------------------------------------------------------+
        |                DONNÉES D'ENTRAÎNEMENT                 |
        |  [Texte]   [Images]   [Vidéo/Audio]   [Code Source]   |
        +-------------------------------------------------------+
                                    |
                                    v
        +-------------------------------------------------------+
        |         PRÉ-ENTRAÎNEMENT MULTIMODAL NATIVE            |
        |              (Infrastructures TPU v5p)                |
        +-------------------------------------------------------+
                                    |
            +-----------------------+-----------------------+
            |                                               |
            v                                               v
+-----------------------+                       +-----------------------+
|  GEMINI FLASH / NANO  |                       |   GEMINI PRO / ULTRA  |
| (Latence / Embarqué)  |                       |  (Raisonnement / MoE) |
+-----------------------+                       +-----------------------+
Défis et controverses : les faux pas de Mountain View
L’histoire de Gemini n’a pas été un parcours sans embûches. Deux crises majeures ont marqué son développement :
- La crise de la représentation historique (Février 2024) : La fonction de génération d’images intégrée à Gemini a provoqué une polémique internationale après avoir généré des représentations historiquement anachroniques (soldats allemands de 1944 ou pères fondateurs américains représentés avec une diversité ethnique erronée). Cet épisode a contraint Sundar Pichai à présenter des excuses publiques et à suspendre temporairement la génération de portraits d’êtres humains.
- Le risque de centralisation des données : Avec l’intégration de Gemini dans Gmail, Google Docs et Android, des questions éthiques et réglementaires émergent concernant le traitement des données privées en Europe (conformité avec l’AI Act et le RGPD).
Bilan et perspectives pour l’écosystème IA
Gemini a permis à Google de combler son retard initial face à OpenAI et Microsoft. En misant sur la multimodalité native, des fenêtres de contexte inédites et une infrastructure matérielle propriétaire, le géant américain s’est positionné comme l’un des piliers incontournables de l’intelligence artificielle générale (AGI).
Pour les développeurs et les entreprises, Gemini représente aujourd’hui une alternative robuste aux modèles GPT, particulièrement performante pour l’analyse de documents volumineux, le traitement d’archives vidéo et l’intégration au sein des environnements de mobilité Android. La bataille des modèles de fondation ne fait que commencer, mais l’architecture de Google DeepMind a prouvé sa capacité d’adaptation et de passage à l’échelle.
Contenu bloqué
Ce contenu vient de YouTube et dépose des cookies. Il s'affichera dès que vous l'aurez autorisé.